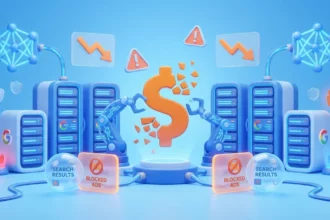
Google a déréférencé 9 sites français d’infos générées par IA de son fil Discover, représentant 2% du flux total. Motifs invoqués : spam massif, cloaking, auteurs fictifs et contenus non vérifiés. Cette première action d’envergure survient après que Google a durci ses règles pour privilégier le « travail humain » face à la pollution par contenus automatisés.
L’offensive nocturne de Google contre les contenus IA
C’est pendant que la France dormait, dans la nuit du 3 au 4 novembre 2026, que Google a dégainé. Neuf sites d’actualités générés par intelligence artificielle ont disparu de Google Discover, ce fil de recommandations qui apparaît sur nos smartphones avant même qu’on ne tape une recherche. Une disparition brutale, sans préavis, orchestrée depuis les États-Unis par les équipes anti-spam du géant de Mountain View.
L’information a été révélée par 1492.vision, un outil de surveillance qui analyse en temps réel les contenus mis en avant par Discover. « Avis de tempête sur Discover France », alertait la plateforme sur X (ex-Twitter). Les neuf sites représentaient à eux seuls environ 2% des articles servis quotidiennement aux utilisateurs français – une part qui peut sembler modeste, mais considérable à l’échelle du trafic généré.
Le timing interpelle : quatre jours plus tôt, le média Next INpact avait précisément interrogé Google au sujet de huit de ces sites. Coïncidence ou déclencheur ? Google n’a pas commenté officiellement, mais les faits parlent d’eux-mêmes. Cette action marque un tournant dans la stratégie du moteur de recherche face à la prolifération des contenus générés automatiquement.
Spam, cloaking et auteurs fantômes : l’acte d’accusation
Les courriels envoyés par Google aux éditeurs sanctionnés ne laissent aucune place au doute. L’acte d’accusation est lourd : « problèmes de spam majeurs », « utilisation abusive de contenus à grande échelle », « techniques de dissimulation (cloaking) » et manquements « répétés ou flagrants » aux règles anti-spam.
Derrière ce jargon technique se cachent des pratiques bien concrètes. Le cloaking, par exemple, consiste à montrer un contenu différent aux robots de Google et aux visiteurs humains – une forme de tromperie sophistiquée pour manipuler le référencement. Quant à l’« utilisation abusive de contenus à grande échelle », elle désigne cette production industrielle d’articles générés en quelques secondes par des IA comme ChatGPT ou GPT-4, sans vérification ni valeur ajoutée humaine.
Google a récemment durci ses règles éditoriales. Le moteur exige désormais de « vérifier manuellement » les contenus générés par IA et de privilégier le « travail humain » aux pages produites automatiquement. Exit aussi les profils d’auteurs fictifs, ces signatures inventées de toutes pièces pour donner une apparence de crédibilité à des textes robotisés.
La sanction appliquée est la plus sévère de l’arsenal Google : une pénalité manuelle. Contrairement aux fluctuations algorithmiques classiques, cette décision a été prise par un humain après examen. Pour les sites concernés, c’est un coup potentiellement fatal : disparition complète de Discover, qui représente souvent 50 à 80% de leur trafic. Pour espérer revenir, ils devront refondre leurs contenus en profondeur et demander un réexamen – une procédure longue, coûteuse, avec un taux de succès inférieur à 20%.
Qui sont ces sites bannis ?
Ni Google ni 1492.vision n’ont publié la liste complète des neuf sites sanctionnés. On sait seulement que huit d’entre eux figuraient régulièrement dans le Top 10 des sites d’infos GenAI établi par 1492.vision, et qu’ils avaient fait l’objet de l’enquête de Next INpact fin octobre.
Ces sites partagent un profil type : publication massive (parfois plus de 200 articles par jour), couverture de tous les sujets d’actualité sans ligne éditoriale claire, absence de journalistes identifiables, style rédactionnel générique et répétitif. Certains allaient jusqu’à utiliser des techniques de cloaking pour tromper les algorithmes de détection.
Leur disparition brutale de Discover illustre la fragilité du modèle économique des « fermes à contenus ». Entièrement dépendants du bon vouloir de Google, ces sites peuvent voir leur audience s’effondrer du jour au lendemain, sans recours efficace. Une précarité qui contraste avec l’apparente facilité de leur croissance initiale.
Une action symbolique ou un vrai tournant ?
Neuf sites bannis, 2% du flux Discover concerné : l’action de Google est-elle suffisante ? Les chiffres suggèrent que non. Si ces neuf acteurs représentaient 2% du flux, cela signifie que 98% reste potentiellement pollué par d’autres sites GenAI non détectés ou tolérés.
Selon plusieurs experts SEO, des centaines de sites similaires continuent d’opérer sous le radar. Google a choisi de frapper les plus visibles, ceux qui apparaissaient régulièrement dans les classements publics, pour envoyer un signal fort. Une stratégie de « regulation by embarrassment » : agir quand la réputation est en jeu, suite à une exposition médiatique gênante.
Le timing – quatre jours après l’enquête de Next INpact – suggère que les médias traditionnels conservent un pouvoir d’influence sur les géants tech. En documentant publiquement les dérives, ils peuvent forcer des changements de politique sans attendre des régulations qui mettent des années à se concrétiser.
Pour autant, cette offensive marque un tournant idéologique chez Google. Après vingt ans à promouvoir l’automatisation et l’algorithmique à tout crin, le moteur de recherche réhabilite la valeur du travail humain. Un aveu implicite : l’IA seule ne peut pas produire de l’information de qualité. Un message qui résonne bien au-delà du seul secteur des médias.
Quelles conséquences pour l’écosystème ?
Dans les semaines qui viennent, une vague de demandes de réexamen va déferler sur les équipes de Google. Les neuf sites bannis tenteront de se mettre en conformité, avec un taux de succès attendu inférieur à 30%. Certains pourraient porter plainte pour abus de position dominante, même si les précédents juridiques sont peu encourageants.
Pour les centaines d’autres sites GenAI encore en activité, c’est la panique. Beaucoup vont tenter de se mettre en conformité dans l’urgence : embaucher des relecteurs humains, créer de vrais profils d’auteurs, réduire les cadences de publication. D’autres, plus sophistiqués, développeront des techniques de camouflage plus élaborées pour échapper à la détection.
Les médias traditionnels, eux, voient une opportunité de regagner du terrain sur Discover. Après avoir été marginalisés par les fermes à contenus, ils pourraient récupérer des positions et du trafic. Reste à savoir si Google maintiendra la pression ou si cette action restera symbolique.
Du côté des annonceurs, la question se pose : continuer à acheter de la publicité sur des sites GenAI à risque, ou privilégier des médias établis plus chers mais plus sûrs ? Les budgets publicitaires pourraient se redéployer, fragilisant encore le modèle économique des contenus automatisés.
Trois scénarios pour les prochains mois
Scénario 1 – Le grand nettoyage : Google étend les pénalités à des centaines de sites GenAI en Europe dans les six prochains mois. Le modèle économique des fermes à contenus s’effondre. Les médias traditionnels regagnent du terrain. Un label « certifié humain » émerge, valorisé par l’algorithme.
Scénario 2 – Le statu quo : Google se contente de ces neuf bannissements symboliques et laisse les autres GenAI tranquilles s’ils restent discrets. Le marché s’autorégule : les acteurs les plus grossiers disparaissent, les plus sophistiqués (modèles hybrides IA + humain) survivent et prospèrent.
Scénario 3 – L’escalade technologique : Course aux armements entre GenAI (IA de plus en plus indétectable, techniques de « humanisation » des textes) et Google (détection de plus en plus fine). Google finit par exiger une déclaration obligatoire des contenus IA, sous pression réglementaire européenne (AI Act, DSA).
Quel que soit le scénario, une question demeure : où placer le curseur entre automatisation et intervention humaine ? Un article relu par un humain suffit-il ? Faut-il qu’un journaliste expert réécrive 50% du texte ? Google n’a publié aucune guideline précise, laissant planer une incertitude qui donne au géant un pouvoir discrétionnaire considérable.
Au-delà de Google : une bataille pour l’avenir de l’information
Cette affaire dépasse largement le cadre d’une simple querelle technique entre Google et quelques sites opportunistes. Elle cristallise une collision entre deux révolutions : l’IA générative qui démocratise la création de contenu, et la crise du modèle économique des médias traditionnels.
Les sites GenAI ont exploité une faille : Google ne savait pas (ou ne voulait pas) distinguer un article écrit par un journaliste d’un texte généré en dix secondes par GPT-4. Résultat : une course au volume plutôt qu’à la qualité, une désinformation potentielle à grande échelle, et une question existentielle pour le moteur de recherche : comment rester pertinent quand l’IA peut inonder le web de milliards de pages ?
D’autres acteurs observent attentivement. Microsoft (Bing), qui a massivement investi dans l’IA avec OpenAI, pourrait adopter une stratégie différente – accueillir les GenAI bannis par Google pour gagner des parts de marché. Les nouveaux moteurs IA-native comme Perplexity ou You.com pourraient aussi voir une opportunité.
L’Union européenne, de son côté, prépare le terrain réglementaire. L’AI Act, applicable dès 2025, pourrait imposer un étiquetage obligatoire des contenus générés par IA. Le Digital Services Act (DSA) renforce la responsabilité des plateformes sur les contenus qu’elles diffusent. Un cadre qui pourrait rendre la triche impossible – ou simplement déplacer le problème vers des plateformes moins régulées.
Ce que vous pouvez faire
Pour les professionnels du secteur : auditez immédiatement votre usage de l’IA. Identifiez tous les contenus générés automatiquement et mettez en place une vérification humaine systématique. Documentez votre processus éditorial pour prouver à Google qu’un expert intervient. Diversifiez vos sources de trafic pour ne plus dépendre à 80% de Discover. Surveillez vos analytics : une chute brutale de trafic peut signaler une pénalité silencieuse.
Pour le grand public : soyez vigilant. Si un article semble générique, sans signature claire d’un journaliste identifiable, avec un style robotique, c’est probablement de l’IA. Privilégiez les médias reconnus avec de vraies rédactions. Méfiez-vous des sites qui publient 50 articles par jour sur tous les sujets : aucune équipe humaine ne peut suivre ce rythme.
L’émergence d’outils de détection (GPTZero, Originality.ai) et de surveillance (1492.vision) crée un nouvel écosystème de contre-pouvoir face à l’opacité des plateformes. Un métier émerge : « auditeur indépendant des algorithmes », documentant et critiquant les décisions arbitraires des géants tech.
Conclusion : la revanche de l’humain ?
En bannissant ces neuf sites, Google envoie un message : l’IA seule ne suffit pas. Le « travail humain », l’expertise, la vérification – ces valeurs que vingt ans d’automatisation avaient reléguées au second plan – redeviennent centrales. Un revirement idéologique qui pourrait annoncer une tendance plus large dans d’autres secteurs : customer service, création de contenu, modération.
Mais ne nous y trompons pas : cette action reste limitée. Deux pour cent du flux, neuf sites sur des centaines. Google a frappé les plus visibles pour calmer la tempête médiatique. Le vrai test viendra dans les mois qui suivent. Google maintiendra-t-il la pression ? Étendra-t-il les pénalités ? Publiera-t-il des règles claires ?
Une certitude : la bataille entre contenus automatisés et information de qualité ne fait que commencer. Et dans cette guerre, nous sommes tous concernés – professionnels, lecteurs, citoyens. Car c’est notre capacité collective à distinguer le vrai du faux, le substantiel du superficiel, qui est en jeu. À l’ère où l’IA peut produire des millions d’articles par jour, la rareté n’est plus l’information, mais la confiance. Google l’a compris. Reste à voir s’il agira en conséquence.