⚡ L’essentiel
OpenAI annonce trois avancées majeures : GPT-6 Astra peut corriger le modèle Qwen en modifiant directement ses paramètres (évitant un réentraînement coûteux), PostgreSQL 19 prend du retard submergé par les bugs détectés par IA, et OpenAI affirme avoir automatisé la recherche de failles dans le noyau Linux. Ces développements marquent l’émergence d’une « IA de maintenance » capable d’auto-corriger l’écosystème numérique, mais soulèvent des questions critiques sur la concentration du pouvoir et la viabilité de l’open source.
Quand l’IA répare l’IA : OpenAI franchit trois seuils technologiques majeurs
Cette semaine, OpenAI a franchi trois seuils technologiques qui redéfinissent les règles du jeu en intelligence artificielle : un modèle capable de réparer d’autres IA sans les réentraîner, une démonstration involontaire que l’IA peut paralyser l’open source, et l’industrialisation de la recherche de failles de sécurité dans Linux. Décryptage de trois ruptures qui bouleversent l’écosystème numérique.
GPT-6 Astra : la chirurgie des neurones artificiels
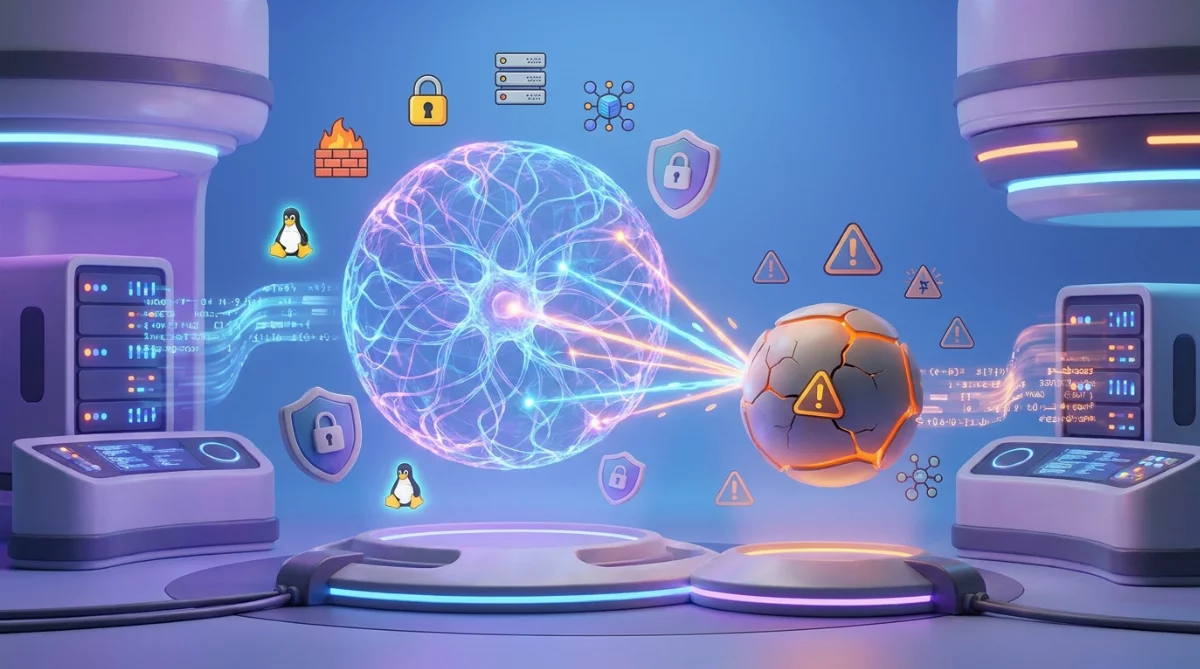
L’annonce la plus spectaculaire concerne GPT-6 Astra, un nouveau modèle d’OpenAI capable de corriger d’autres intelligences artificielles en modifiant directement leurs paramètres internes, sans passer par la case réentraînement. Concrètement, Astra a réussi à réparer le modèle Qwen en retouchant ses « neurones » défaillants, comme un chirurgien interviendrait sur un organe précis plutôt que de refaire toute l’opération.
Pour comprendre la portée de cette innovation, il faut saisir l’ampleur économique du réentraînement. Corriger un modèle comme GPT-4, qui compte environ 1 700 milliards de paramètres, coûte des dizaines de millions de dollars et nécessite plusieurs semaines de calcul intensif. C’est l’équivalent de refaire entièrement une formation professionnelle au lieu de suivre une simple mise à niveau ciblée.
Selon OpenAI, cette approche permettrait de réduire les coûts de maintenance des modèles d’IA de 70 à 90%. Un bouleversement potentiel pour toute l’industrie du MLOps (gestion opérationnelle des modèles d’IA), où les solutions de réentraînement représentent actuellement un marché de plusieurs milliards de dollars.
Mais cette capacité soulève aussi des questions vertigineuses. Si une IA peut « réparer » un autre modèle, peut-elle aussi le saboter ? Cette technologie s’apparente à CRISPR pour le code génétique : précise, puissante, et potentiellement dangereuse. La sécurité des modèles d’IA n’est plus seulement une question de données d’entraînement, mais de protection de leurs paramètres internes contre des modifications externes malveillantes.
PostgreSQL submergé : quand l’aide devient paralysie
La deuxième actualité révèle un paradoxe inattendu de l’automatisation : PostgreSQL 19, l’une des bases de données open source les plus utilisées au monde (par Apple, Instagram, Spotify), prend du retard à cause… de l’IA censée l’aider.
Le problème ? Les systèmes automatisés de détection de bugs génèrent un tel volume de signalements que l’équipe de mainteneurs – quelques dizaines de développeurs bénévoles et salariés – ne peut physiquement pas tous les traiter. Quand l’IA signale 10 000 bugs potentiels en une semaine, elle crée un goulot d’étranglement qui annule ses bénéfices.
C’est le premier cas documenté d’une IA ralentissant un projet en voulant l’aider. Un signal d’alarme pour tous les projets open source, dont le modèle repose sur la contribution humaine volontaire. Ces communautés ne sont tout simplement pas dimensionnées pour absorber le débit des contributions automatisées.
Cette crise illustre une tension fondamentale : l’IA génère de la valeur (détection de bugs) plus vite que les humains ne peuvent la traiter. Sans infrastructure de triage automatique – elle-même basée sur l’IA – pour filtrer les vrais positifs des faux positifs, l’automatisation devient contre-productive. Un nouveau marché émerge : celui des « IA de triage » capables de hiérarchiser les signalements automatiques.
Linux sous surveillance automatisée : industrialisation de la cybersécurité
La troisième annonce concerne la sécurité informatique. OpenAI affirme avoir « industrialisé » la recherche de failles dans le noyau Linux, le cœur du système d’exploitation qui fait tourner 90% des serveurs internet, les smartphones Android, et l’infrastructure cloud mondiale.
Transformer un processus artisanal – des experts cherchant manuellement des vulnérabilités – en chaîne automatisée capable d’analyser des millions de lignes de code 24h/24 change radicalement l’équation. Avant, un expert en sécurité découvrait 5 à 10 failles par mois. Avec l’IA, le potentiel grimpe à des centaines par jour.
Mais cette industrialisation pose une question cruciale : qui contrôle ces découvertes ? OpenAI a-t-il divulgué les failles de manière responsable à la communauté Linux, ou les garde-t-il pour lui ? La politique de divulgation n’a pas été précisée dans l’annonce.
Plus fondamentalement, cette technologie est « dual-use » : elle sert autant les défenseurs que les attaquants. Si OpenAI peut automatiser la découverte de failles, des acteurs malveillants peuvent développer des outils similaires. Nous entrons dans une course aux armements où l’IA sert simultanément les deux camps, augmentant potentiellement le risque systémique plutôt que de le réduire.
Une stratégie de plateforme déguisée en prouesses techniques
Le timing de ces trois annonces simultanées n’est probablement pas un hasard. OpenAI ne démontre pas seulement des capacités techniques isolées, mais une « verticalité » : modifier des modèles, auditer du code, sécuriser des systèmes. L’entreprise se positionne comme le « système d’exploitation de l’IA », la couche intermédiaire obligatoire entre les différents modèles et applications.
C’est une stratégie de plateforme comparable à celle de Microsoft avec Windows dans les années 1990. Si OpenAI réussit à s’imposer comme l’infrastructure incontournable pour maintenir, auditer et sécuriser les IA, cela lui confère un pouvoir de marché considérable – et une valorisation potentiellement comparable aux géants tech actuels.
Cette concentration soulève des enjeux géopolitiques. Seuls ceux qui contrôlent les « méta-IA » – les IA capables de modifier, auditer et corriger d’autres IA – pourront efficacement gérer les systèmes critiques. Les nations et entreprises sans ces capacités devront faire confiance à OpenAI, Google DeepMind ou Anthropic pour la sécurité de leurs infrastructures. Un nouveau levier de pouvoir, comparable au contrôle des semi-conducteurs ou des ressources énergétiques.
Entre promesses et vaporware : la nécessité de la vérification
Malgré l’enthousiasme médiatique, plusieurs zones d’ombre subsistent. OpenAI « affirme » avoir industrialisé la chasse aux failles Linux, mais aucune validation indépendante n’a été publiée. Combien de vulnérabilités ont été découvertes ? Quelle est leur criticité ? Quel est le taux de faux positifs ?
De même, les détails techniques sur GPT-6 Astra restent flous. Peut-il modifier n’importe quel modèle, ou seulement ceux d’architectures similaires ? Les modèles « réparés » conservent-ils leurs performances globales, ou subissent-ils des régressions ailleurs ? Ces questions déterminent si nous sommes face à une percée réelle ou à une opération de communication.
La communauté scientifique et technique attend désormais des publications académiques, des benchmarks indépendants et des retours d’expérience concrets. Dans un secteur où les annonces spectaculaires se multiplient pour maintenir l’attention des investisseurs, la vérification rigoureuse devient cruciale.
Implications concrètes pour les professionnels
Pour les équipes techniques, ces développements imposent une adaptation rapide. Les coûts de maintenance des modèles d’IA pourraient chuter drastiquement si la modification directe de paramètres se généralise, bouleversant les business plans des projets en cours. Les compétences valorisées évoluent : moins de recherche manuelle de bugs, plus d’audit et de validation des découvertes automatisées.
Les mainteneurs de projets open source font face à une crise existentielle. Comment gérer 100 fois plus de signalements sans 100 fois plus de ressources ? La solution passe probablement par des partenariats avec des entreprises capables de fournir l’infrastructure de triage automatique, créant de facto une dépendance du monde open source envers le secteur privé.
Pour les investisseurs, plusieurs pistes se dessinent : les startups développant des IA de triage pour l’open source (marché vierge), les entreprises spécialisées dans l’audit de découvertes automatisées (nouveau maillon de la chaîne de valeur), et les fournisseurs d’infrastructure pour la modification de paramètres (alternative au réentraînement). À l’inverse, les solutions de MLOps traditionnelles centrées sur le réentraînement pourraient voir leur valorisation chuter de 60 à 80%.
Scénarios pour les 6-12 prochains mois
Plusieurs futurs sont possibles. Dans un scénario d’« industrialisation », la modification directe de paramètres devient standard, les coûts chutent, et le marché se consolide autour de trois ou quatre acteurs maîtrisant cette technologie. PostgreSQL et projets similaires adoptent des IA de triage, créant un nouveau marché B2B.
À l’opposé, un scénario de « backlash » verrait la communauté open source rejeter massivement les contributions automatisées, créant des « zones sans IA ». Une réglementation stricte sur les méta-IA pourrait émerger, surtout si les annonces d’OpenAI se révèlent exagérées.
Un scénario intermédiaire de « bifurcation » dessinerait deux écosystèmes parallèles : un monde « IA-natif » intégrant massivement l’automatisation, et un monde « human-first » privilégiant la contribution humaine. Cette fragmentation du paysage numérique créerait des incompatibilités et des tensions entre les deux approches.
Enfin, un scénario de « course aux armements » verrait l’industrialisation de la recherche de failles déclencher une escalade en cybersécurité, avec des incidents majeurs causés par des attaquants utilisant les mêmes outils. Cela pourrait déclencher une intervention gouvernementale et une militarisation de l’IA de sécurité.
Conclusion : l’ère des méta-capacités
Ces trois annonces marquent l’entrée dans l’ère des « méta-capacités » : les IA ne se contentent plus d’exécuter des tâches, elles modifient d’autres IA, détectent leurs propres bugs, et automatisent la sécurité informatique. Cette évolution concentre le pouvoir chez les acteurs capables de développer ces méta-IA, redessine l’économie de l’open source, et transforme la cybersécurité en course industrielle.
La question centrale n’est plus « qui contrôle les données », mais « qui contrôle les IA qui modifient les IA ». Une question qui déterminera les équilibres de pouvoir dans le monde numérique des prochaines années. Reste à savoir si ces annonces spectaculaires résisteront à l’épreuve de la vérification technique, ou si elles rejoindront la longue liste des promesses non tenues de l’industrie tech.