⚡ L’essentiel
Les coding agents entrent dans une nouvelle phase : l’orchestration multi-modèles remplace l’usage systématique du modèle le plus puissant. Cette approche route chaque tâche vers le modèle optimal selon sa complexité, réduisant les coûts de 40-70 % tout en améliorant latence et gouvernance. Un changement de paradigme qui transforme l’économie de l’IA en développement logiciel.
La fin du « tout-puissant » en IA de développement
Imaginez embaucher un neurochirurgien pour poser un pansement. C’est exactement ce que font encore beaucoup d’entreprises avec leurs coding agents : elles mobilisent GPT-6 Astra ou Claude Fable 5.1 — les modèles d’IA les plus puissants et coûteux du marché — pour corriger une simple faute de syntaxe ou générer une fonction basique.
Après trois ans d’euphorie où la course était à la puissance maximale, l’industrie entre dans une phase de maturation. Selon les analyses récentes du secteur, 70 à 80 % des tâches de codage sont relativement simples et ne nécessitent pas la puissance d’un modèle frontière. Pourtant, les factures d’API explosent, représentant parfois 15 à 30 % du budget IT dans certaines organisations.
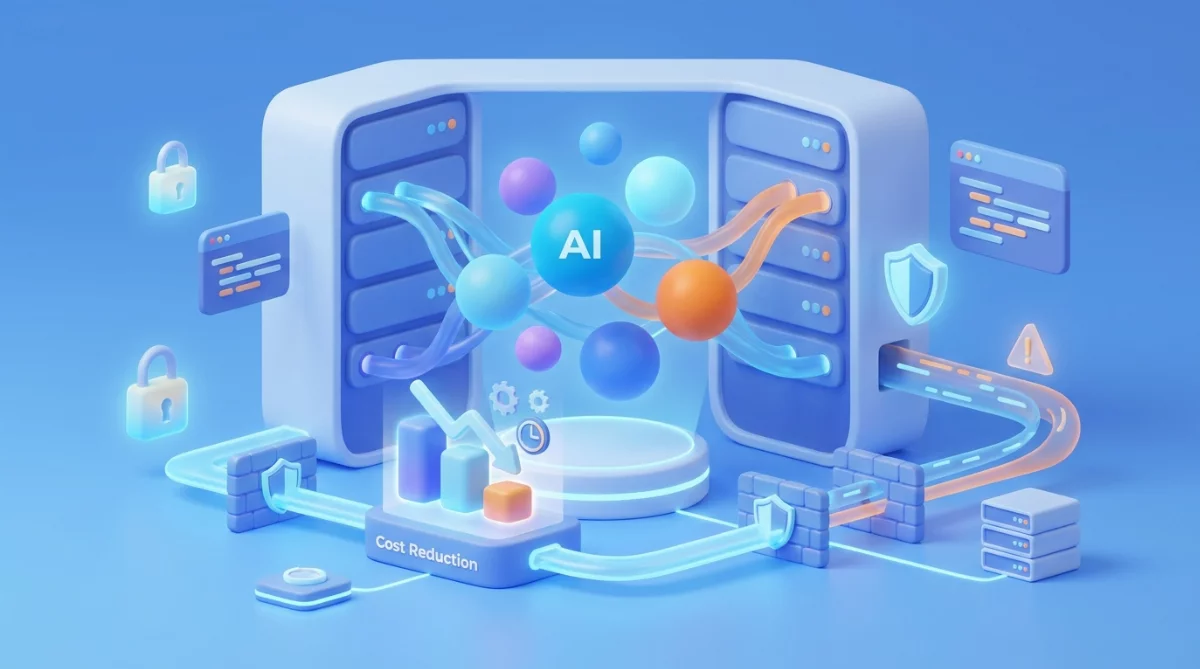
L’orchestration multi-modèles apporte une réponse pragmatique : au lieu d’un seul « cerveau » surpuissant, elle coordonne plusieurs modèles d’intelligence variable et sélectionne automatiquement le plus adapté selon la complexité de chaque tâche. Comme un chef d’orchestre qui choisit quel instrument joue à quel moment.
Comment fonctionne l’orchestration multi-modèles
Le principe repose sur une catégorisation intelligente des tâches de développement. Une correction de syntaxe, l’ajout d’un commentaire ou la génération d’un test unitaire simple peuvent être confiés à un modèle léger comme GPT-3.5 ou DeepSeek V4 Flash — jusqu’à 10 fois moins coûteux que leurs homologues premium.
À l’inverse, l’architecture d’un système complexe, le refactoring d’une base de code legacy ou la résolution d’un bug subtil justifient l’intervention de Claude Opus 5 ou GPT-6 Astra. La différence de coût est considérable : environ 0,003 dollar par 1 000 tokens pour un modèle léger contre 0,03 dollar pour un modèle frontière.
Des benchmarks récents montrent que le choix du harness — la couche logicielle qui pilote le modèle — peut faire varier les coûts d’un facteur 5 sans changement significatif du taux de réussite. Une étude menée par l’Université de Californie à Berkeley et Arena a comparé 21 combinaisons de sept modèles et trois harnesses : les écarts de performance étaient minimes, mais les écarts de coût spectaculaires.
Gains mesurables et cas d’usage concrets
Les premiers retours d’expérience montrent des réductions de coûts de 40 à 70 % selon les profils d’utilisation. Au-delà de l’économie directe, l’orchestration améliore la latence : les modèles légers répondent trois à cinq fois plus rapidement pour les tâches simples, fluidifiant le workflow des développeurs.
Selon Pexon Consulting, qui documente l’implémentation d’un système multi-agents pour OpenCode, chaque agent peut être configuré avec un modèle différent selon sa spécialité : un modèle rapide pour l’exécution de commandes terminal, un modèle intermédiaire pour la lecture de contexte, un modèle puissant pour la planification stratégique.
Anthropic a récemment relancé la fonctionnalité Projects dans Claude Code comme une couche de contrôle pour orchestrer plusieurs agents en parallèle. Chaque projet maintient un mémo partagé et peut lancer des threads de travail sur des branches Git distinctes, avec un coordinateur qui résout les conflits sous forme de pull requests. Cette architecture illustre la tendance : l’intelligence ne réside plus dans un seul modèle, mais dans la coordination de plusieurs.
Les défis de mise en œuvre
L’orchestration multi-modèles n’est pas une solution miracle. Elle introduit une complexité opérationnelle : gérer plusieurs contrats fournisseurs, plusieurs APIs, plusieurs versions de modèles. La traçabilité devient plus ardue quand différentes parties du code sont générées par des modèles différents avec des « styles » distincts.
Une étude publiée en août 2026 a révélé que les coding agents voient leur performance chuter de 7,7 % lorsque les utilisateurs modifient le code en cours de tâche — un phénomène amplifié dans les architectures multi-modèles où la cohérence contextuelle est plus difficile à maintenir.
Par ailleurs, comment mesurer objectivement la « complexité » d’une tâche pour router vers le bon modèle ? Les critères restent débattus. Certaines plateformes utilisent des heuristiques simples (nombre de fichiers impactés, présence de tests), d’autres s’appuient sur un modèle de classification dédié — ajoutant une couche de coût et de latence.
Un nouveau paysage concurrentiel
Cette évolution redistribue les cartes du marché. Les fournisseurs de modèles premium (OpenAI, Anthropic) subissent une pression baissière si les entreprises réduisent leur usage des modèles coûteux. À l’inverse, les acteurs mid-tier et open-source (Mistral, Meta avec Llama, Alibaba avec Qwen) gagnent en légitimité : leur modèle devient viable pour 70 à 80 % des cas d’usage.
Un nouveau segment émerge : les plateformes d’orchestration. Des startups comme Martian, Portkey.ai ou les frameworks open-source LangChain et LlamaIndex se positionnent comme intermédiaires indispensables. Elles ne produisent pas de modèles, mais maîtrisent la couche de routage intelligent — un avantage stratégique difficile à répliquer.
Selon les données d’Artificial Analysis, le classement des coding agents ne se lit plus seulement par modèle, mais par configuration complète : modèle + harness + stratégie d’orchestration. Sur le benchmark DeepSWE v1.1, les écarts entre configurations optimisées se comptent en points, mais les écarts de coût peuvent atteindre 300 %.
Implications pour les équipes de développement
Pour les développeurs, le changement est d’abord invisible : l’orchestration doit idéalement fonctionner en arrière-plan, sans modifier le workflow. Mais à moyen terme, de nouvelles compétences émergent : comprendre les forces et faiblesses de chaque modèle, calibrer les seuils de routage, interpréter les métriques de coût par tâche.
Les DSI et CTOs doivent repenser leur stratégie d’approvisionnement. L’audit de l’utilisation actuelle devient prioritaire : identifier quelles tâches mobilisent quels modèles, à quel coût, avec quel taux de réussite. Les premières entreprises à déployer l’orchestration lancent des POC sur des projets pilotes, mesurent les gains réels, puis généralisent.
La gouvernance se complexifie également. Tracer quel modèle a généré quel code, contrôler que les données sensibles ne transitent pas par des APIs externes, auditer les décisions de l’IA : autant de défis amplifiés par la multiplication des modèles. L’AI Act européen, qui impose des obligations de transparence et de traçabilité, pourrait rendre l’orchestration plus contraignante à documenter.
Perspectives : vers une IA « suffisante » plutôt que maximale
Au-delà de l’optimisation technique, l’orchestration multi-modèles marque un changement de philosophie. L’industrie passe de « maximiser l’intelligence » à « optimiser l’intelligence suffisante » — un principe que l’économiste Herbert Simon appelait « satisficing » : chercher une solution satisfaisante plutôt qu’optimale.
Ce pragmatisme pourrait ralentir la course aux armements en IA. Si 80 % des besoins sont couverts par des modèles mid-tier, l’investissement massif dans les modèles frontières devient moins justifiable économiquement. Cela pourrait favoriser une adoption plus durable et responsable de l’IA, avec une empreinte carbone réduite.
À court terme (6 mois), attendez-vous à des annonces d’orchestration native par les principaux éditeurs de coding agents (GitHub, JetBrains, Cursor). Les benchmarks comparatifs vont se multiplier, avec des métriques standardisées sur le coût par tâche terminée. À moyen terme (18 mois), plusieurs scénarios coexistent : standardisation de l’orchestration comme norme de l’industrie, consolidation autour d’écosystèmes fermés (Microsoft, Google, Amazon), ou disruption par les modèles open-source qui égaleraient les modèles propriétaires.
Conclusion : le bon modèle au bon moment
L’orchestration multi-modèles n’est pas une mode passagère, mais une réponse structurelle à un problème économique réel. Elle illustre la maturation de l’IA générative : après l’expérimentation tous azimuts, vient le temps de l’efficience opérationnelle.
La question n’est plus « quel est le meilleur modèle ? » mais « quel est le meilleur modèle pour cette tâche précise ? ». Une nuance qui transforme radicalement l’économie du développement assisté par IA. Les entreprises qui maîtriseront cette orchestration — techniquement, économiquement, et sur le plan de la gouvernance — prendront un avantage compétitif durable.
Et vous, votre organisation est-elle prête à passer d’un modèle unique à une symphonie de modèles coordonnés ?
Sources et references
- LLM Cost Optimization (2026): Cut Spend 30% in 90 Days – futureagi.com (source fiable)
- What Is Multi-Model Orchestration? A Complete Guide – truefoundry.com (source fiable)
- What Is an AI Coding Agent? The Complete 2026 Guide – developersdigest.tech (source fiable)
- AI Coding Models Leaderboard — AICoder – aicoder.com (source fiable)
- The State of AI Coding Agents (August 2026): Adoption, Terminal-Bench, and the Stack Devs Actually Run – contracollective.com (source fiable)
- IA Agentique 2026 : Claude Fable 5.1 vs ChatGPT Agent – tech-insider.org (source fiable)