TL;DR
Jev est le premier « System One Model » de TypeSafe AI : une IA qui ne rédige rien, mais renvoie des décisions typées (choix, note, probabilité) en 70 à 500 millisecondes. Fondée par Diogo Almeida, co-inventeur du RLHF utilisé dans ChatGPT, la startup promet des gains de vitesse et de coût drastiques pour automatiser le tri, le routage et la classification. Mais attention : aucun benchmark indépendant n’a encore validé ces chiffres.
Jev : l’IA qui décide en 100 ms au lieu de rédiger pendant 3 secondes
TypeSafe AI vient de sortir de l’ombre avec Jev, un modèle d’intelligence artificielle qui ne génère aucun texte. À la place, il tranche : il classe, note et choisit en quelques centaines de millisecondes, promettant d’être jusqu’à 200 fois plus rapide et 400 fois moins coûteux que les grands modèles de langage pour des tâches de décision structurée.
Une IA qui refuse d’écrire une seule phrase
L’annonce a fait du bruit sur les réseaux sociaux mi-septembre 2026. Diogo Almeida, ancien chercheur chez OpenAI et co-auteur des travaux sur le RLHF (la méthode qui a permis à ChatGPT de suivre des instructions), présente Jev comme le premier représentant d’une nouvelle catégorie : les System One Models.
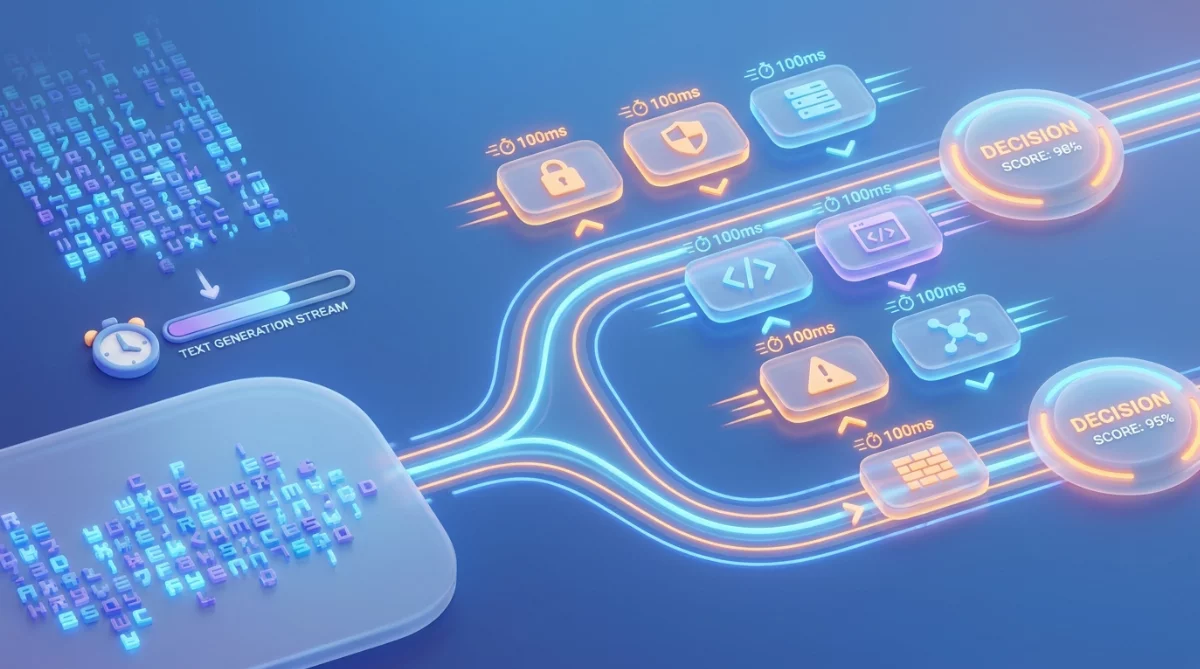
Le concept rompt avec la logique des grands modèles de langage (LLM) comme GPT-4, Claude ou Gemini. Ces derniers génèrent du texte mot après mot, token par token, de manière séquentielle. Jev, lui, ne rédige rien. Il reçoit un contexte (un email, un ticket client, un extrait de document) et une liste de questions fermées. En une seule passe parallèle, il renvoie des réponses structurées : un choix parmi des options prédéfinies, une note sur une échelle, ou une probabilité oui/non.
Selon TypeSafe AI, cette approche « appel de fonction » permet d’obtenir des réponses en 70 à 500 millisecondes, là où un LLM conversationnel met plusieurs secondes. Le coût annoncé ? 0,042 dollar par million de tokens en entrée, avec les tokens de sortie gratuits. À titre de comparaison, GPT-4 facture environ 30 dollars par million de tokens en entrée.
Comment fonctionne Jev : trois primitives, zéro prose
Jev s’appuie sur trois types de questions, que TypeSafe appelle des « primitives » :
- Choice : choisir une option parmi un ensemble fermé (jusqu’à 255 options). Exemple : classer un email en « urgent », « normal » ou « spam ».
- Score : attribuer une note selon une échelle ordonnée. Exemple : évaluer la qualité d’un commentaire de 1 à 5.
- Noul : estimer la probabilité qu’une affirmation soit vraie. Exemple : « Ce message contient-il une demande de remboursement ? » (réponse : 87 % de confiance).
Chaque réponse est accompagnée d’un niveau de confiance, calculé grâce à une nouvelle méthode baptisée RLCD (Reinforcement Learning for Calibrated Decisions). TypeSafe affirme que cette calibration garantit des probabilités « honnêtes » : quand Jev dit être sûr à 90 %, il devrait avoir raison 90 % du temps.
L’architecture technique repose sur un échantillonneur parallèle : toutes les questions d’une requête sont évaluées simultanément, contrairement aux LLM qui traitent les informations de manière séquentielle. Cette parallélisation explique en partie les gains de vitesse annoncés.
Des promesses spectaculaires, mais aucune validation indépendante
TypeSafe AI avance des chiffres impressionnants : jusqu’à 200 fois plus rapide et 400 fois moins cher que les LLM pour des tâches de classification, routage ou notation. L’entreprise cite des exemples concrets : un service client recevant 10 000 emails par jour pourrait automatiser le tri et l’orientation sans passer par un modèle conversationnel coûteux.
Problème : à ce jour, aucun benchmark indépendant n’a validé ces performances. Les seuls chiffres disponibles proviennent de TypeSafe elle-même. La communauté technique attend des tests en conditions réelles, sur des jeux de données publics, pour confirmer ou nuancer ces promesses.
Autre nuance importante : TypeSafe affirme que Jev « ne peut pas halluciner », car sa sortie est contrainte par un schéma prédéfini. C’est techniquement vrai au niveau du format (Jev ne va pas inventer une catégorie qui n’existe pas), mais cela ne garantit pas la justesse de la décision. Jev peut très bien classer un email urgent en « normal » avec 95 % de confiance. L’absence d’hallucination structurelle ne signifie pas l’absence d’erreur de classification.
Qui est Diogo Almeida, et pourquoi son nom compte
Diogo Almeida se présente comme « co-inventeur de ChatGPT ». Le titre est un peu exagéré. Plus précisément, il est l’un des co-auteurs d’un papier fondateur sur le RLHF, publié en mars 2022. Cette méthode d’apprentissage par renforcement à partir de retours humains a permis aux modèles GPT de passer de générateurs de texte bruts à des assistants capables de suivre des instructions et de converser de manière cohérente.
Son parcours chez OpenAI et Google Brain lui confère une crédibilité certaine. Mais c’est aussi un positionnement stratégique : en lançant Jev, Almeida critique implicitement l’approche des LLM généralistes qu’il a contribué à créer. Son message ? Les modèles conversationnels sont surdimensionnés pour la plupart des tâches d’automatisation en entreprise.
Une rupture dans la logique de l’IA d’entreprise
L’arrivée de Jev illustre une tendance de fond : la spécialisation de l’IA. Après la course aux modèles généralistes toujours plus gros (GPT-4, Gemini, Claude 3.5), le marché s’oriente vers des outils optimisés pour des tâches précises. C’est l’équivalent logiciel du passage des CPU généralistes aux GPU et TPU spécialisés.
Cette logique répond à une préoccupation croissante des DSI : le retour sur investissement de l’IA. Beaucoup de projets pilotes utilisant des LLM ne passent pas en production, notamment à cause du coût d’inférence. Utiliser GPT-4 pour classer des emails, c’est comme prendre un avion de ligne pour faire 10 kilomètres : techniquement possible, économiquement absurde.
Jev propose un compromis : sacrifier la flexibilité (pas de génération de texte, pas de conversation) pour gagner en vitesse, en coût et en fiabilité sur des tâches bien définies. C’est le pari du « right-sizing » : utiliser le bon outil pour le bon usage.
Cas d’usage : où Jev pourrait faire la différence
TypeSafe cible plusieurs domaines où les décisions structurées dominent :
- Service client : trier automatiquement les demandes par catégorie (facturation, support technique, réclamation) et niveau d’urgence.
- Modération de contenu : classer les messages en « acceptable », « à vérifier » ou « interdit » avec un niveau de confiance.
- Routage de workflows : orienter des documents vers le bon service en fonction de leur contenu.
- Guardrails pour LLM : vérifier si une réponse générée respecte des critères (ton professionnel, absence de données sensibles, etc.).
- Scoring et notation : évaluer la qualité d’un CV, d’un commentaire client ou d’une proposition commerciale selon des critères prédéfinis.
Dans tous ces cas, l’entreprise n’a pas besoin que l’IA rédige une explication. Elle veut une décision rapide, fiable et exploitable par un système automatisé. C’est exactement ce que promet Jev.
Les limites et zones d’ombre
Plusieurs questions restent en suspens :
1. Performances réelles : les benchmarks indépendants manquent. Impossible de vérifier si Jev tient ses promesses face à des LLM optimisés (GPT-4 en mode JSON, Claude avec structured outputs) ou à des modèles de classification traditionnels (XGBoost, random forests).
2. Généralisation : comment Jev se comporte-t-il sur des domaines non vus pendant l’entraînement ? Les LLM ont montré une capacité de transfert impressionnante. Jev peut-il en faire autant, ou faut-il le réentraîner pour chaque nouveau cas d’usage ?
3. Calibration réelle : la promesse de probabilités « honnêtes » est cruciale. Mais la calibration dépend fortement de la qualité des données d’entraînement et de la proximité entre les données de test et de production. Un modèle bien calibré en laboratoire peut se dégrader rapidement en conditions réelles.
4. Modèle économique : TypeSafe n’a pas encore communiqué de grille tarifaire détaillée. Le prix de 0,042 dollar par million de tokens est une base, mais qu’en est-il des volumes minimums, des SLA, des options d’auto-hébergement ?
5. Dépendance à un fournisseur unique : Jev inaugure une nouvelle catégorie sans concurrent établi. Les entreprises qui l’adoptent prennent un risque de lock-in technologique.
Réactions du marché et perspectives
L’annonce a suscité un intérêt immédiat dans la communauté tech. Sur X (ex-Twitter), le post de Diogo Almeida a généré des milliers de réactions. Plusieurs développeurs ont demandé un accès anticipé pour tester Jev sur leurs cas d’usage. Des intégrateurs comme Vercel AI Gateway et Cloudflare ont rapidement ajouté Jev à leur catalogue.
Mais des voix critiques se font aussi entendre. Certains experts soulignent que les LLM modernes, avec leurs modes de sortie structurée (JSON mode, function calling), peuvent déjà accomplir ce que fait Jev. La vraie différence, selon eux, réside dans l’optimisation : Jev sacrifie la généralité pour gagner en efficacité sur un segment précis.
D’autres s’interrogent sur la taille du marché adressable. Les tâches de « décision pure » représentent-elles un volume suffisant pour justifier une nouvelle catégorie de modèles ? Ou s’agit-il d’une niche qui restera marginale face aux LLM généralistes ?
Et maintenant ?
Dans les prochains mois, plusieurs développements sont attendus :
- Benchmarks indépendants : la communauté académique et les analystes vont tester Jev sur des jeux de données publics pour valider (ou infirmer) les performances annoncées.
- Retours d’early adopters : les premières entreprises à déployer Jev en production partageront leurs résultats, permettant d’évaluer la calibration et la fiabilité en conditions réelles.
- Réaction des géants : OpenAI, Anthropic et Google pourraient soit développer des équivalents, soit optimiser leurs LLM pour mieux servir les cas d’usage de décision structurée.
- Évolution du modèle économique : TypeSafe devra clarifier sa grille tarifaire, ses SLA et ses options de déploiement (cloud, on-premise, edge).
Au-delà de Jev lui-même, cette annonce pose une question stratégique : l’IA d’entreprise va-t-elle vers une mosaïque d’outils spécialisés ou vers une consolidation autour de quelques plateformes généralistes ? La réponse déterminera les gagnants et les perdants des prochaines années.
Conclusion : une promesse à vérifier
Jev incarne une vision séduisante : une IA qui fait une chose, mais la fait vite, bien et pour pas cher. Pour les entreprises qui automatisent du tri, du routage ou de la classification, c’est potentiellement une révolution économique. Pour les autres, c’est un outil de plus dans une boîte à outils déjà bien remplie.
La crédibilité de Diogo Almeida et l’élégance du concept jouent en faveur de TypeSafe AI. Mais les promesses spectaculaires demandent des preuves spectaculaires. Les prochains mois diront si Jev tient ses engagements ou si l’enthousiasme initial laissera place à une désillusion.
Une question demeure : dans un monde où l’IA généraliste progresse à vitesse grand V, y a-t-il vraiment de la place pour des spécialistes ?
Sources et references
- How to Reduce the Compute and Energy Infrastructure Costs of Deploying Enterprise AI – agxntsix.ai (source fiable)
- TypeSafe Jev: the First Decision-Only Model Class, Benchmarked and Priced – developersdigest.tech (source fiable)
- Modèle Jev expliqué : prix API, usages et accès immédiat – omniakey.com (source fiable)
- What are Large Language Models? – azure.microsoft.com (source fiable)
- Grands modèles de langage : définition et cas d’usage – zendesk.fr (source fiable)
- Jev: TypeSafe’s System One Model That Never Hallucinates – datacamp.com (source fiable)
- Jev de TypeSafe AI, c’est quoi, prix et limites en 2026 – promptfacile.fr (source fiable)
- Jev par TypeSafe AI : Nouveautés, fonctionnement et alternatives (2026) – powerdrill.ai (source fiable)